先说一件小事。
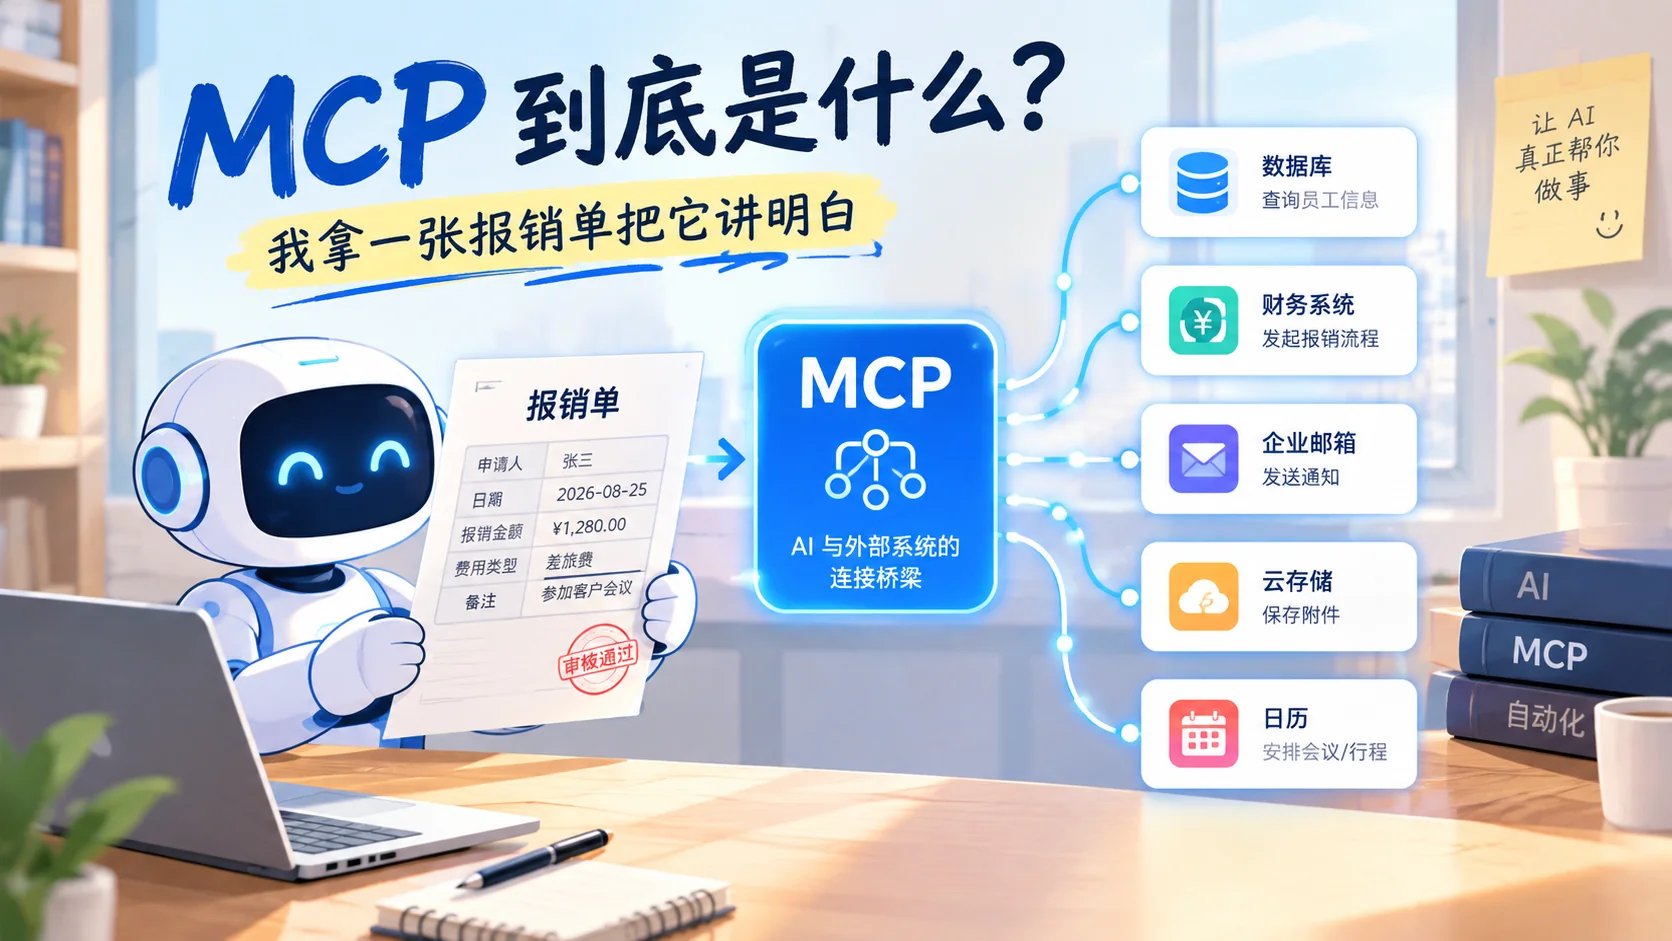
审一张报销单,听起来简单:看单号、看金额、看发票。真做起来是这样一个流程——打开 OA,登录,进报表中心,找到那张单,等三层 iframe 一层层加载出来,抄下流水号、报销人、部门、费用细类,翻到附件区,把 PDF 一张张下下来,再逐张核对发票号、购销双方、税率、价税合计,最后回头跟单子上填的数字对一遍。顺利的话二十分钟,不顺利的时候,光找单入口就耗掉十分钟。
这活儿难吗?一点不难。有技术含量吗?没有。但它每天都在吃掉真正需要判断力的时间,而且没人愿意承认这笔账。
过去两年,AI 已经能读懂这些内容了——把发票 PDF 丢给它,它提要素比人还快。可它伸不出手。它看不见你的 OA,点不动那个"下载附件",更不知道费用细类决定了这张单该附哪些材料。
MCP 就是来解决这个"伸不出手"的问题的。所以这篇不打算从协议文档讲起,就从这张报销单讲起。
MCP 一句话:AI 世界的 USB-C
MCP 的全名是 Model Context Protocol,模型上下文协议。Anthropic 在 2024 年 11 月把它开源出来,官方定义很朴素:一个让 AI 应用连上外部系统的开放标准。业界更爱用的说法是——AI 世界的 USB-C 接口。
这个比喻好在哪?回想一下 USB-C 之前的世界:手机充电器一个口,相机一个口,移动硬盘又一个口,出门得背一袋线。USB-C 做的不多,它只是把"接口长什么样、电和数据怎么走"这件事定死了,然后所有厂商各自去适配。
MCP 干的是同一件事,只不过它统一的是AI 和业务系统之间的对话方式:
- 一边是 AI(Claude、DSH 这类客户端,也叫 Host);
- 一边是你的系统(OA、ERP、数据库、文件柜、工单平台);
- 中间那层 MCP Server 就是转接头,把系统的能力翻译成 AI 听得懂的清单。
协议本身走的是 JSON-RPC 2.0,传输方式两种:跑在本机的用标准输入输出(stdio),跑在远端的用 HTTP。这些细节对使用者只有一个意思——写完一次,任何支持 MCP 的 AI 客户端都能用。今天在 DSH 里能调,明天换个客户端,改一行配置的事。
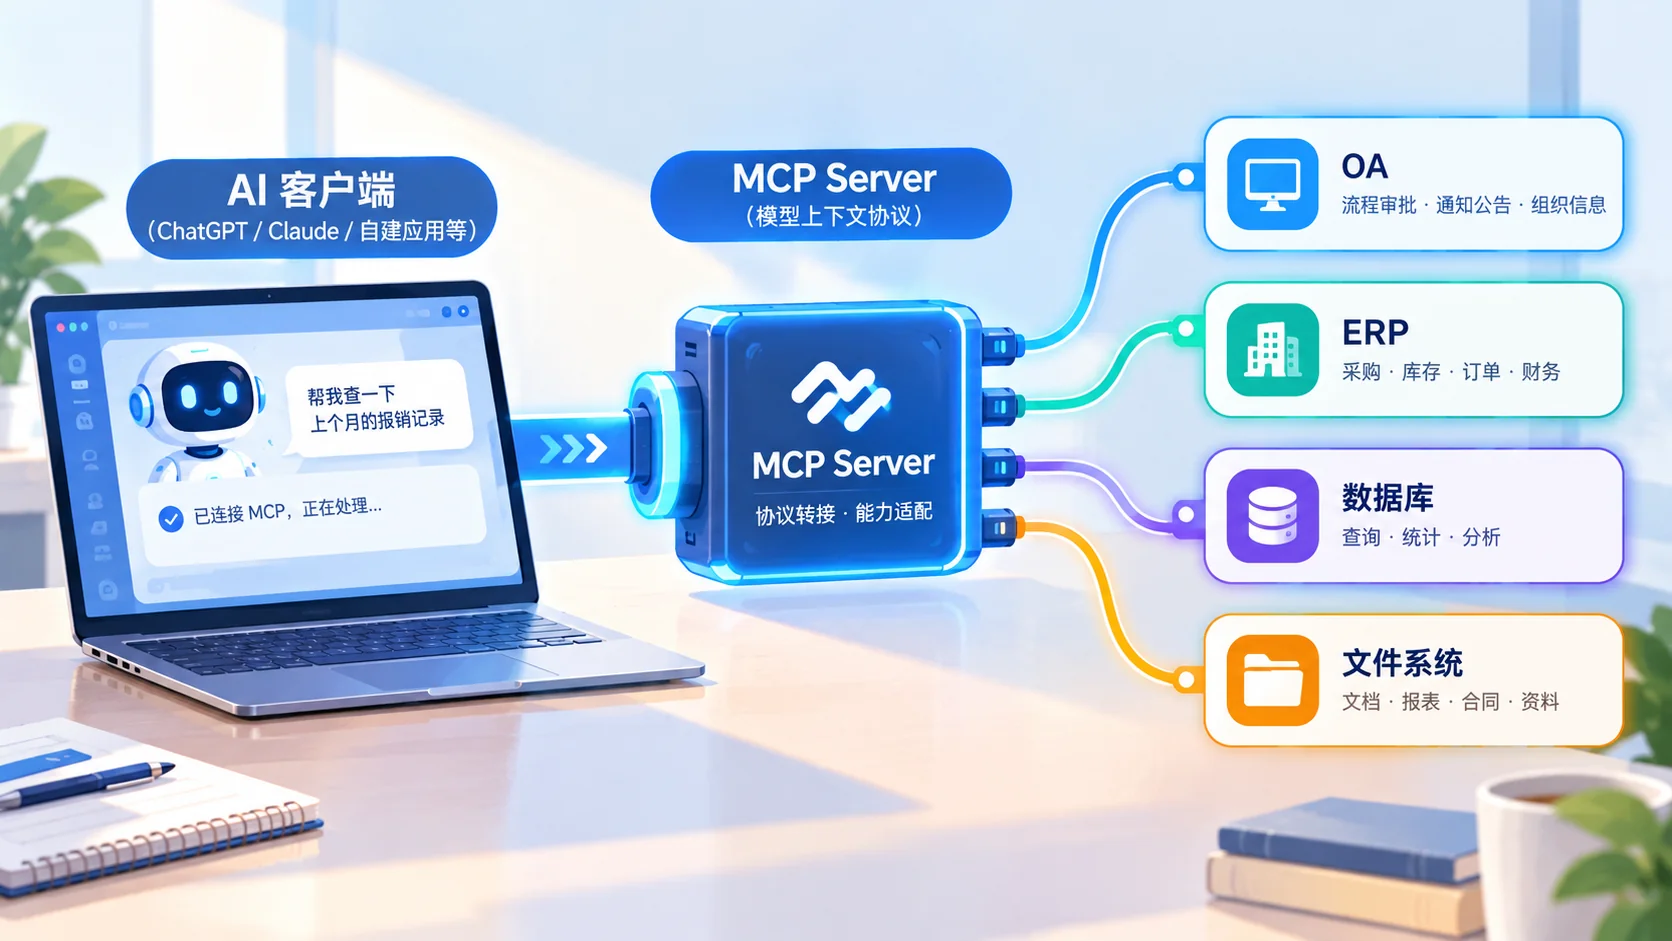
MCP 不发明新能力,它把"让 AI 用上你现有系统的能力"这件事,从一次性定制变成了标准件。
拆开看:一台 MCP Server 只有三块积木
网上讲 MCP 最劝退的地方,是它总在讲架构。其实一个服务器对外提供什么,无非三样东西,而这三样东西的主动权归属完全不同——这一点想通了,MCP 就通了。
| 积木 | 是什么 | 打个比方 | 谁说了算 |
|---|---|---|---|
| Tools(工具) | AI 可以主动调用的函数,有明确的输入输出 | 你去办事,窗口能受理的"业务清单" | 模型决定什么时候调哪个 |
| Resources(资源) | 只读的数据,用来给 AI 补充上下文 | 窗口旁边摆着的公开资料,随便看 | 应用程序决定给不给 |
| Prompts(提示模板) | 预先写好的指令模板,串起工具和资源的用法 | 大厅里贴的"办事指南" | 用户自己挑着用 |
拿我的 OA MCP 举例最直观:
- 工具是
oa_open(打开单据)、oa_page_state(结构化读取表单字段)、oa_download_attachments(批量下载附件)——AI 判断"我现在需要读这张单",它就调; - 资源是公司现行的费用报销制度原文——它不参与决策,只是摆在旁边,AI 需要比对规则时读它;
- 提示模板是"审一张报销单"这套固定动作——用户想跑就点一下,不用每次重新交代一遍要从哪儿读、都要核哪些字段。
除了这三块,协议还留了两个挺妙的机制:Sampling,服务器可以反过来请客户端那边的大模型帮个忙;Elicitation,服务器遇到缺信息时,主动向用户追问一句。它们说的其实是同一件事——MCP 不是单向的"AI 下命令",一次业务操作可以在两边来回好几轮。报销审核正是典型:读单、下发票、比对、发现缺件、追问、出结论,本来就没法一步做完。
补一句现状:MCP 的协议版本号用的是日期格式,目前最新一版是 2026-07-28。它已经交给 Linux 基金会下面的 Agentic AI Foundation 托管,不再是某一家公司的私产——对要把它接进企业内网的人来说,这个归属变化比协议细节更值钱。
它和 Function Calling、RPA 到底差在哪
这是被问得最多的问题。前提得先立住:三者不是替代关系,但分不清它们,力气很容易花错地方。
| 维度 | Function Calling | RPA / 脚本自动化 | MCP |
|---|---|---|---|
| 本质 | 模型调用工具的能力 | 模拟人操作界面的流程机器人 | 工具对外暴露的标准协议 |
| 谁适配谁 | 每个模型、每个工具各写一套 | 每个系统、每次改版各录一遍 | 服务器写一次,所有客户端通用 |
| 变通能力 | 按定义调用,不会自己想办法 | 坐标和控件一变就崩 | AI 按语义自己组合工具,页面微调通常还能扛 |
| 典型失败 | 换个模型就得重写胶水代码 | 对方系统升级一次,流程全废 | 系统改得面目全非时同样会失效 |
| 适合场景 | 固定的几个动作,稳定可控 | 界面高度固定、重复度极高的批量操作 | 跨系统、需要判断和组合的复杂任务 |
我自己的感受是这样的:RPA 像是把一个人的鼠标动作录下来反复播放,动作一变就得重录;Function Calling 是给 AI 提前写好一份"能做的动作清单",可这份清单是给某一个应用写的;MCP 则把"每个工具长什么样"变成了公共约定——谁来读都行,读到的用法也一样。
所以三者其实能叠着用:MCP 管的是"怎么把工具讲清楚",Function Calling 是它在模型侧的表现形式,底层实现照样可以是浏览器自动化,或者干脆直接打接口。我的 OA MCP 就是后者——表面上一组工具,底下是 Playwright 驱动的真浏览器。这种方案的代价也要认:对方界面一改,我就得跟着修。
实战:我做的 OA MCP,把报销审核串起来了
概念说够了,说点手上真的。我给公司在用的那套 OA 写了一个 MCP Server,让它替我干那些翻页、下载、比对的活。
这层"转接头"具体暴露了什么
工具清单不长,但每一个都对应一个真实动作:
| 工具 | 干的活 |
|---|---|
oa_login_status | 探活。OA 是 SSO 单点登录,会话几小时到几天就会过期,动手前先确认还在线 |
oa_open | 打开单据页,并等 iframe 数量稳定——不等的话读到的都是空壳 |
oa_page_state | 结构化读出表单字段:流水号、报销人、部门、金额、费用大类细类、票据张数、税额…… |
oa_list_attachments | 列附件清单,并给出可直接下载的地址 |
oa_download_attachments | 批量下载,可按文件名过滤,比如只下 PDF |
oa_fetch | 借当前登录态调 OA 内部接口,用来按单号直接查数据 |
一张单进去,出来是什么
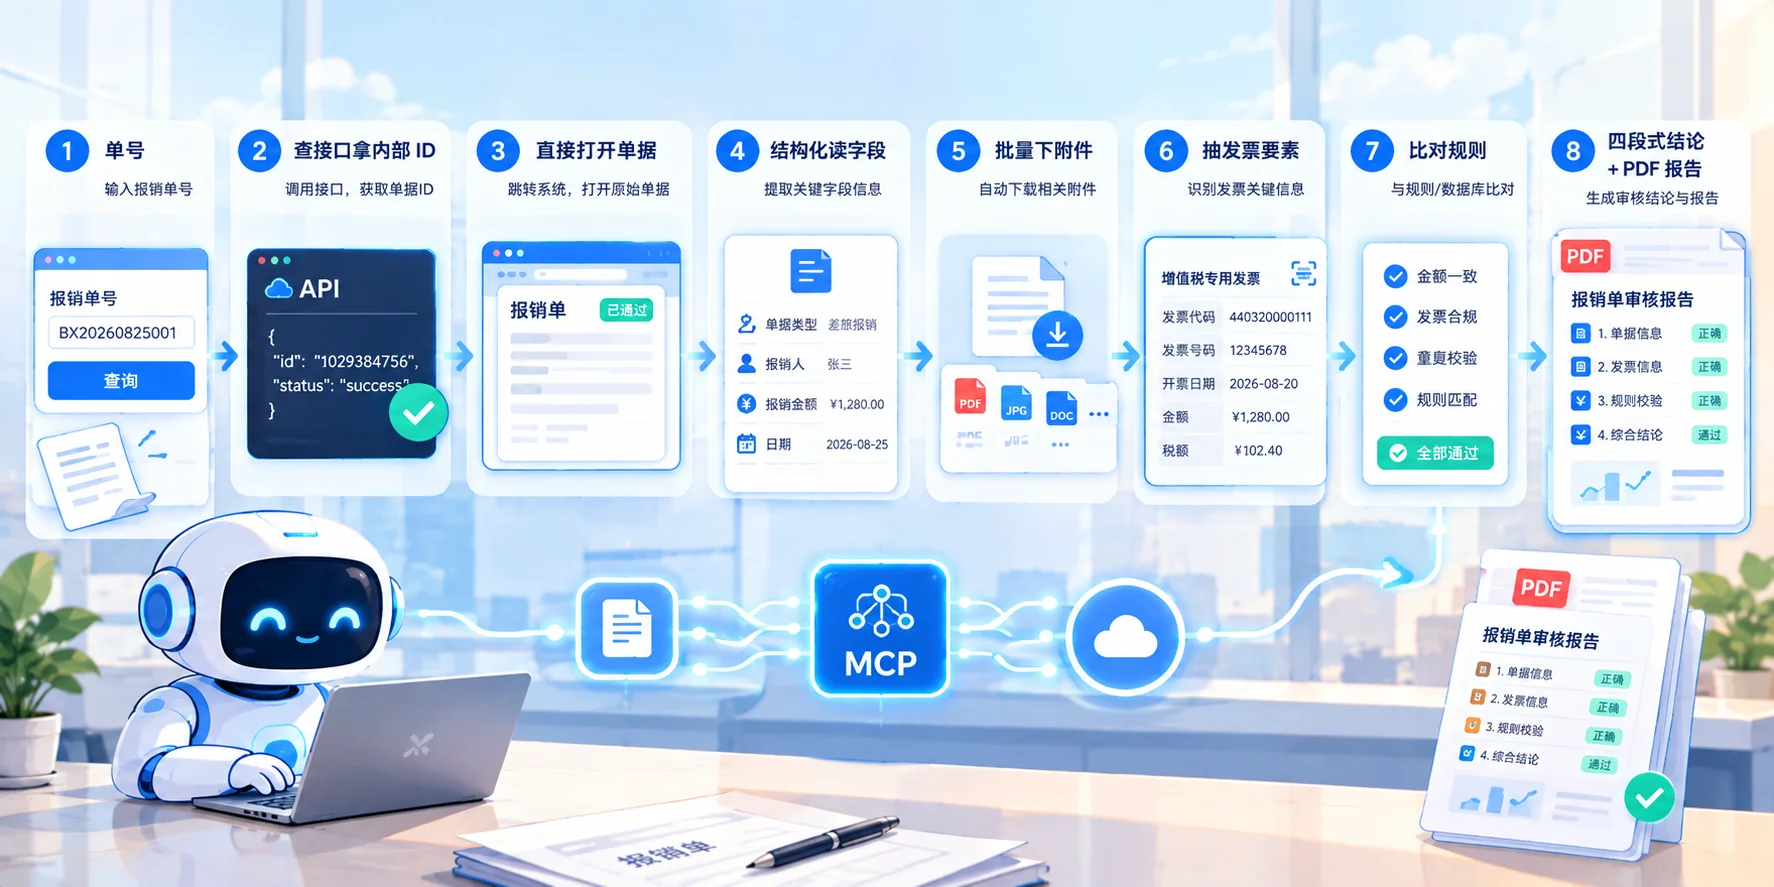
实际跑起来是这样的:我给它一个单号,它自己去把这单查出来,把表单字段和明细读齐;把附件全下载到本地目录;从每张发票里抽出号码、开票日期、购销双方、税率、价税合计;然后逐条对照公司现行的费用报销制度——基础合规、这类费用的必备附件、差旅专项标准、违规特征,最后按"单据事实 / 勾稽核对 / 缺件与风险 / 无法判断的"四块给出结论,并顺手生成一份 PDF 审核报告。
中间有几个坎,是我花时间最多、也最值得写下来的地方:
- 页面读不全。 OA 的表单藏在多层 iframe 里,附件元数据根本不在 DOM 上,只存在于 Vue 的运行时状态里。所以工具不是去"抓页面文字",而是穿透 frame 一层层读,再从运行时状态里把附件信息挖出来。
- 没有输入框工具。 早期文档里写的
oa_type其实并不存在,报表列表和查询结果行又是 JS 绑定点击、没有可点编号。意味着"在搜索框里输单号"这条路根本走不通。 - 那就绕过界面。直接用接口。 既然只有单号,就调 OA 自己的数据接口按流水号过滤,拿到内部 ID,再自己拼出能直接打开单据的链接——把上面那个死胡同走成了直路。
- 登录态是长期的坑。 一个浏览器 profile 只能被一个进程占用,服务端和手工登录会互相抢;会话过期时,最优解不是反复重试,而是请用户在那个已经打开的窗口里点两下登录。
一句话概括这次改造
MCP 这一层没让 AI 变聪明,它做的是把"找单、读单、下附件、抽要素、比对规则、出报告"这六个动作,从人的手上交到了 AI 手上。判断力那部分,一点没动。
对企业来说,这层接口买到的是什么
装完以后回头看,真正变的不是速度,而是工作的形状。
| 环节 | 以前 | 现在 |
|---|---|---|
| 找单 | 登录、进报表中心、层层点开、等加载 | 报一个单号 |
| 读字段 | 肉眼抄,抄错要重来 | 结构化输出,字段不漏 |
| 下附件 | 一张张点,改名、归档 | 批量落盘,按类型过滤 |
| 核对发票 | 逐张打开比发票号和金额 | 自动提取要素与单据字段勾稽 |
| 对规则 | 凭记忆,容易漏项 | 按费用类型套对应必备附件清单 |
| 结论与留痕 | 口头说、事后补备忘 | 四段式结论 + PDF 报告同时产出 |
更关键的是口径的一致。这件事以前靠人记:张三记得团建费要附申请表和照片,李四只记得要发票。规则一旦写进 MCP 和它配套的技能说明里,每次走的都是同一套清单、同一个判断标准。人在这种重复劳动上的稳定性,本来就比不过流程。
但也得说句实话:AI 读不到的东西,一样读不到。最终入哪个科目、东西有没有真的发放、这一笔该不该批——这些答案不在单据里。所以能交出去的是"找和查",不能交出去的是"判和担"。这不只是技术限制,更是权责边界。守住这条线,工具才敢用;守不住,省下的时间还不够赔一次错。
想给自己业务接一个 MCP,我会先问四个问题
这四条不是判断"能不能做",而是判断"值不值得做"。
上手前的检查清单
- 这件事值不值得标准化? 天天做、步骤固定、跨系统、判断标准清晰——值得。一个月做一次、每次都不一样——不值得。
- 系统有没有稳定入口? 有官方接口最好;只能靠浏览器自动化也能做,但要接受对方改版你就得跟进。
- 最坏情况是什么? 只读不写是安全的;一旦涉及提交、审批、付款、删除,就必须停在最后一步让人点。我的 OA MCP 全程只读和下载,从不替我批单。
- 数据边界在哪? 单独用一套独立的浏览器配置,别和网银、管理员账号混用;涉及身份证号、银行账号、客户信息先脱敏;日志别把敏感字段全记下来。
还有一条经验:先把规则写清楚,再谈工具。我花在整理公司报销制度上的时间,比写代码多得多——哪类费用必须附什么、单笔多少钱以上要合同、差旅超标该走哪级审批。这些没理清楚,MCP 再顺,也只是让错误跑得更快。
一句话总结
MCP 不是新模型,也不是新工具,它是一个接口标准。它把"让 AI 用上企业现有系统"这件事,从每家各写一套胶水代码,变成一层可以复用的转接头。
对企业来说,它的价值顺序是这样的:先统一接口,再沉淀规则,然后才是自动化动作。跳过前两步直接上自动化,得到的往往是一个跑得很快、但方向不一定的流程。
至于我,最大的收获不是省下了审批的时间。是这些时间终于可以用在真正需要人的地方——去问业务这单为什么这么花,而不是先花二十分钟把它找出来。
本文核验依据
- MCP 官方文档:Understanding MCP servers:核对 Tools / Resources / Prompts 三类能力定义及"谁说了算"的分工。
- MCP 官方文档:Versioning:核对日期式版本号规则与当前协议版本 2026-07-28。
- Linux Foundation / Agentic AI Foundation:核对 MCP 已转入中立基金会托管这一治理变化。