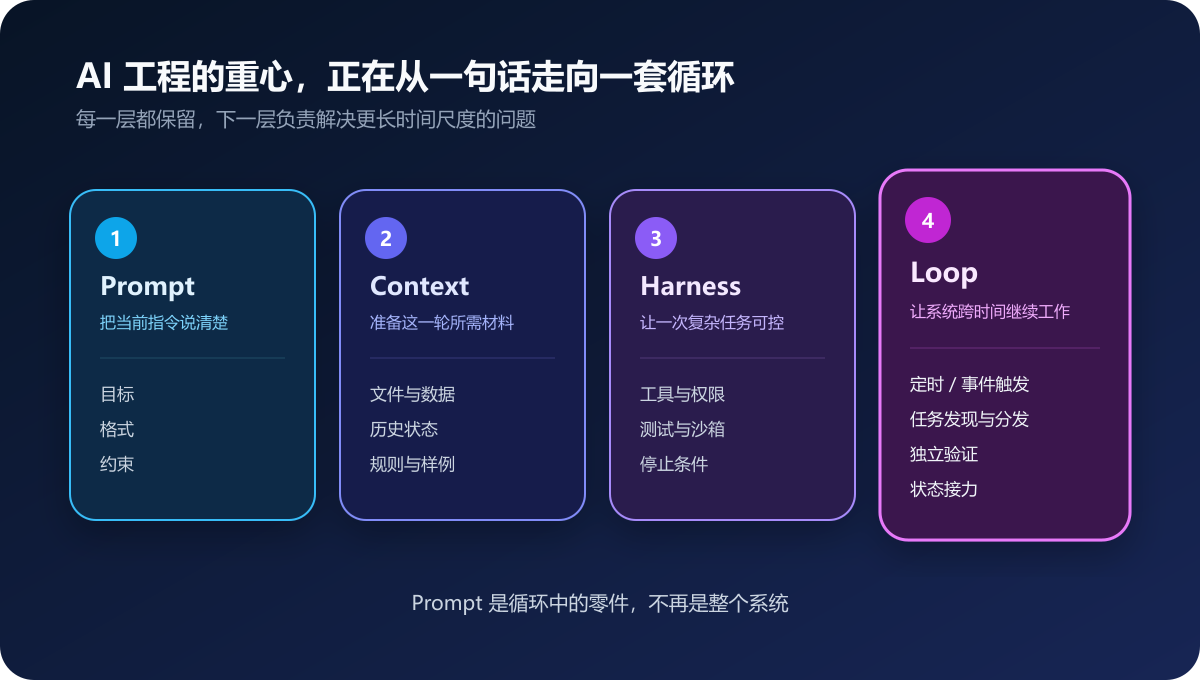
上个月月底,我把一份 38 页的年报丢给 Agent,让它算三个数:营业收入增速、毛利率、经营活动现金流净额。
它用了 40 秒,给了三个数。
三个都错了。
第一个,它把“营业总收入”当成了“营业收入”,多算了一笔其他业务收入。第二个,毛利率用了母公司报表,不是合并报表。第三个更离谱,它把“现金及现金等价物净增加额”当成了经营活动现金流。
我换了个更贵的模型,又跑了一遍。这次错得少了一点,但错得更隐蔽:一张跨页的表格,它把下一页的表头当成了数据,毛利率算出来 71%。
我后来手工算了一遍,真实毛利率是 23%。
那天晚上我想明白一件事:它不是不聪明。它缺的是眼睛。
这一年我几乎每周都看 GitHub 热榜。2026 年 10 月第一周,中文社区那份按周涨星排的飙升榜,前 20 个项目里有 12 个和 Agent 有关:运行时、记忆、技能包、浏览器、MCP。10 月 20 日更新的 star 榜,n8n 二十万星,Dify 十五万星,markitdown 十九万星。
热闹是真的。
但如果你在财务口待过,会发现一个错位:这些项目大多在解决“Agent 怎么活得久、怎么记住事、怎么互相协作”,而财务每天卡住的地方是另外三件事——这份 PDF 读不对,这个数算错了,这个系统点不进去。
所以这篇不推荐“必装的十个项目”。我想说清楚的是:一个财务 Agent 到底缺哪几块,GitHub 上哪些项目能补上,以及我试过之后,哪些又卸掉了。
本文目录
它缺的不是脑子
模型是脑子。工具是手脚。工作流是习惯。
大部分人装 Agent,先换脑子。这个模型不行换那个,参数越调越大。但你把一份扫描件、一张合并单元格的表、一个没有 API 的 OA 系统摆在它面前,脑子再好也没用。它看不见,也够不着。
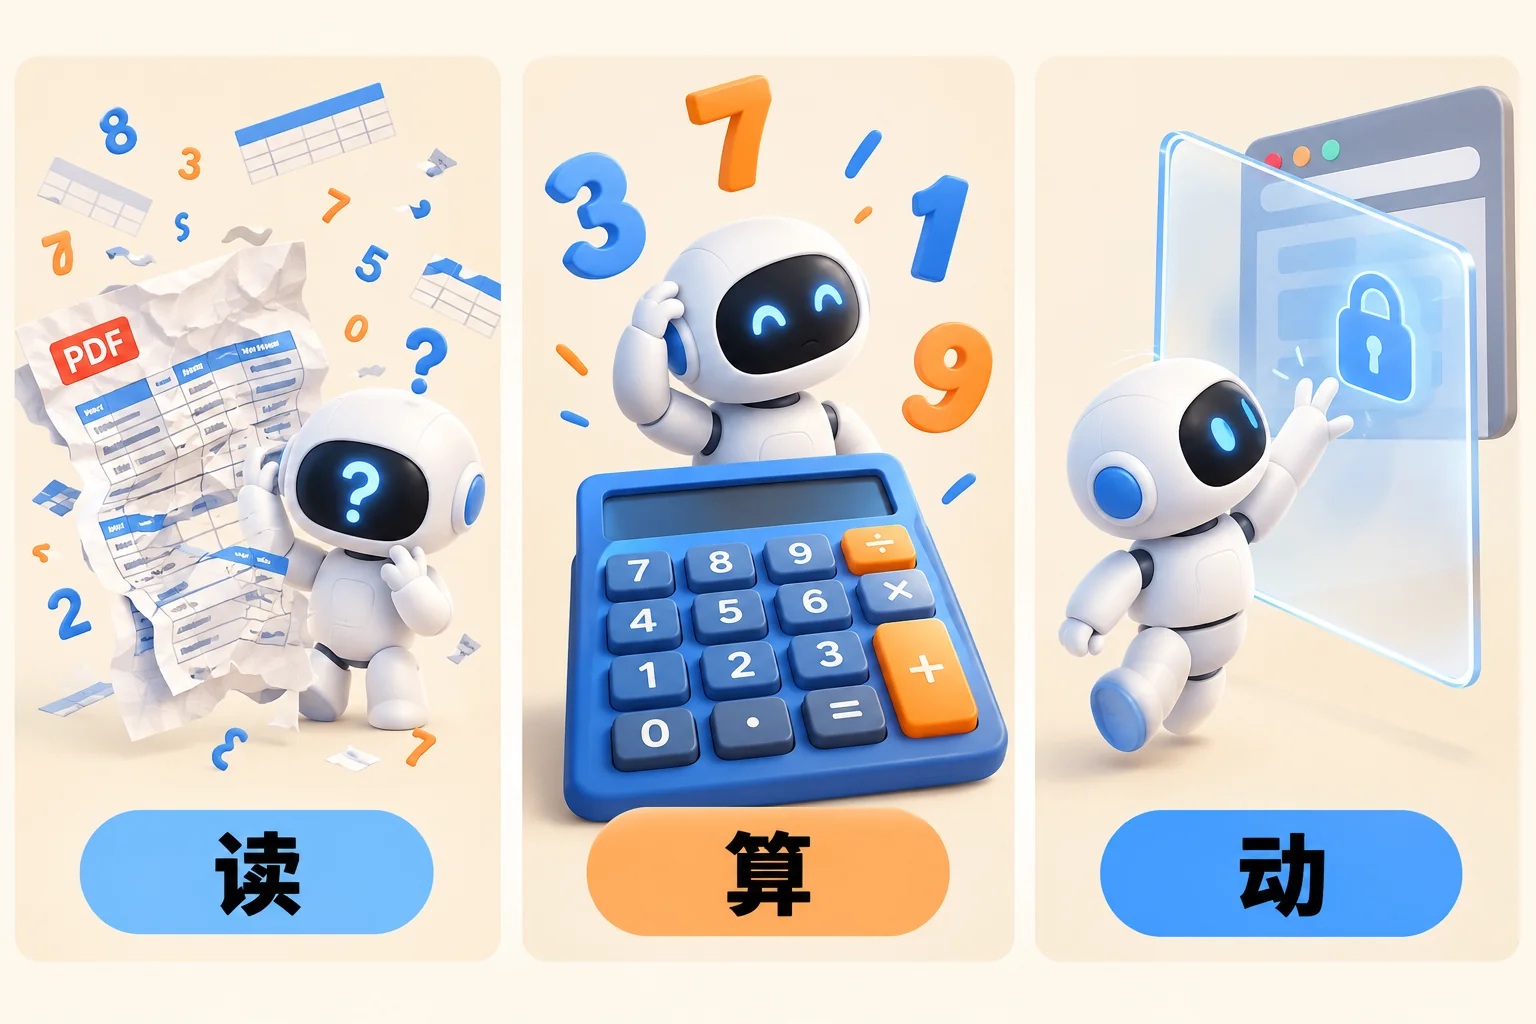
财务的活,拆开只有三类:
- 读:单据、合同、发票、年报、审计报告。
- 算:口径、勾稽、差异、分摊、汇总。
- 动:在 OA、ERP、网银、税局、供应商门户里点、导、传。
我自己的体感是,财务 Agent 八成的失败发生在“读”和“动”,不在“想”。“想”这件事,模型已经够用了;“读”和“动”要靠工具,而工具得有人给它装。
| 卡住的地方 | 具体表现 | 该补的能力 | 对应的项目类型 |
|---|---|---|---|
| 读 | 跨页表错位、扫描件糊、单位看错 | 版面理解 + OCR | MinerU、Docling、PaddleOCR |
| 算 | 心算错、口径混、结果不可复算 | SQL / 公式引擎 | DuckDB、Univer、formulas |
| 动 | 系统没 API、验证码、登录态过期 | 浏览器自动化 | Playwright、browser-use |
还有一个反例,我想先说:多智能体。
今年热榜上不少项目在讲“Agent 团队”——一个负责规划,一个负责执行,一个负责审核,互相开会。听着很像财务部的分工。
我试过之后,结论是:一个会用五个工具的单 Agent,比五个只会聊天的 Agent 靠谱。
财务流程的瓶颈是数据和权限,不是“人手不够”。你给 Agent 配三个“同事”,它们还是读不对那张跨页表。
生成后放到 /blog/images/ 即可
眼睛:把 PDF 读成能算的东西
财务文档的脏,是通用的三倍。
年报有跨页表、合并单元格,页眉页脚里还藏着“单位:万元”;发票是扫描件,公章压住金额;合同是 Word,修订记录里有两版价格;银行回单是图片,柜员章的红色盖住了摘要。
你让模型直接“看”这些文件,它看到的是被压扁的文本流。表格顺序乱了,数字和科目对不上,单位丢了。它还是很自信地给你一个数。
这就是为什么“眼睛”要单独装。
MinerU 是我用得最顺手的一个。它已经到 4.0,支持 PDF、图片、Word、PPT、Excel、OFD、CSV,解析分四档:flash、basic、standard、advanced。flash 快,适合先看个大概;standard 和 advanced 慢,但表格和公式稳。
它有两个设计,是专门为 Agent 做的。
一个是 skill。装好之后,Agent 自己知道“遇到 PDF 先调 mineru”,不用你在提示词里教。另一个是 locator。解析结果带页码和块号,Agent 可以“先读第 1 到 10 页,不够再读第 11 页”,不用一次把 38 页塞进上下文。你问毛利率,它只需要去利润表那几页。
mineru-kit parse 2025年报.pdf -o 2025年报.md --tier standardDocling 是另一条路。IBM 起的项目,MIT 协议,本地跑。它的强项是版面:阅读顺序、表格结构、公式、图片分类。README 里有一句我特别在意——它支持 XBRL 财报解析。
XBRL 是什么?简单说,是上市公司财报的“结构化原件”。交易所和监管要的是这个,不是 PDF。你如果能直接读 XBRL,很多“从 PDF 里抠数字”的活根本不用干。
Docling 还自带 MCP server 和 docling-serve,可以当成一个本地服务,让 Agent 通过 MCP 调。不想写太多胶水代码的人,这条路更省事。
markitdown 更轻。微软出的,把 Word、PPT、Excel、邮件、HTML 转成 Markdown。它的定位是“给 LLM 吃的文本”,不是“高保真还原”。表格能转,但复杂表头会丢。我的用法是:Word 合同、PPT 汇报、邮件用它;年报和扫描件,交给 MinerU 或 Docling。
PaddleOCR 是另一类。它不做版面理解,只做 OCR——把图片里的字认出来。扫描件、发票、银行回单,先用它把字提出来,再自己拼结构。中文识别很稳,但“表格结构”它不管。
| 你手上的文件 | 我一般用什么 | 原因 |
|---|---|---|
| 原生 PDF 年报 | MinerU / Docling | 表格和版面是强项 |
| 扫描件、发票、回单 | PaddleOCR + 模板 | 先认字,再拼字段 |
| Word 合同、PPT | markitdown | 轻,够用 |
| 上市公司财报原件 | Docling(XBRL) | 结构化,不用从 PDF 里抠 |
生成后放到 /blog/images/ 即可
我试项目的顺序,跟大部分人反过来。我不先看 star,我先拿自己最脏的一份文件试。
第一步,只跑三页——封面、目录、一张最复杂的表。看表格有没有错位。第二步,看它失败时报什么错。是“解析失败”,还是“第 7 页表格跨页,已合并”?后者说明作者想过这件事。第三步,看它能不能只读一部分。年报 38 页,我只需要利润表那 3 页;一个只会“整份转”的工具,在 Agent 里很难用。
那份年报,12 张表,MinerU 出来 11 张能用,1 张跨页表错位。我手工修了 10 分钟。
10 分钟,比让模型“再想想”快得多,也比它可靠。
计算器:别让模型心算
模型会算数,但它算得不稳定。
同一个毛利率,你问三遍,它可能给你三个略有差异的数。它不是在算,是在“生成一个看起来像算过的数”。金额小的时候看不出来,到了百万、千万级,差一位就是事故。
所以财务 Agent 的第二件工具,是计算器。而且这个计算器要能留痕。
DuckDB 是我现在的主力。嵌入式分析数据库,一个文件就能跑,读 CSV、Parquet 很快,Excel 装个扩展也能读。1.5.6 版,MIT 协议。
它最大的好处不是快,是“可复算”。Agent 写的 SQL 留在文件里,你随时能重跑;结果不对,看 SQL 就知道错在哪一步。模型只负责写 SQL 和解释结果,不负责算。
SELECT customer,
       SUM(revenue) AS revenue,
       SUM(cost) AS cost,
       ROUND((SUM(revenue) - SUM(cost)) / SUM(revenue), 4) AS gross_margin
FROM read_csv_auto('orders_2026.csv')
GROUP BY customer
ORDER BY gross_margin ASC;
这段 SQL 跑出来的结果,和 Agent 嘴上说的数,是两回事。我只看 SQL 跑出来的。
Univer 是今年我觉得最值得关注的一个。它不是“又一个在线 Excel”,而是给 Agent 用的 Office SDK:表格、文档、演示,带公式引擎,能在 Node.js 里 headless 跑,Apache-2.0。
什么意思?Agent 可以打开一个工作簿,改几个单元格,触发重算,再把结果读回来;人在浏览器里看到的是同一份文件,可以复核、可以改。它还有 MCP 集成,能把表格能力直接挂给 Agent。
10 月第一周那份榜单里,它一周涨了四千星。热归热,但它是少数“热度”和“财务场景”对得上的项目。
formulas 是另一种工具。它能把 Excel 公式解析出来,重新算一遍。我主要用它干一件事:复算别人发来的模型。
财务收到的预算表、估值表,经常是“数是对的,但不知道哪来的”。里面藏着硬编码、断链、循环引用。formulas 能把公式树拆开,告诉你这个数到底引用了谁。它是 EUPL-1.1 协议,内部用没问题,对外分发要注意。
我的原则只有一句
财务 Agent 的输出必须可复算。同样的输入,同样的 SQL 或公式,跑出来同样的结果;错的时候,能指出错在第几步。做不到这一条,它给的只是“看起来对的数”,不是财务结论。
一个具体流程:Agent 读需求 → 写 SQL → DuckDB 跑 → 结果落 Parquet → 人抽查 5 行 → Agent 解释差异 → 人确认。
模型在第一步和第五步出现。中间那几步,交给数据库。
手:那些没有 API 的系统
财务系统是最不“API 友好”的一类系统。
OA 有 API 的少,网银基本没有,税局门户一年改两次版,供应商对账平台要短信验证码。你让 Agent“去把上个月的报销单附件下下来”,它连登录框都过不去。
这时候需要“手”。
browser-use 是这两年被讨论最多的浏览器 Agent。MIT 协议,Python 库,用自然语言描述任务,它自己找按钮、填表单、翻页。0.13 版,能接本地 Chrome,复用你的登录态;也有 CLI 和 skill,装到 Claude Code、Codex 这类工具里就能用。
它的优点是“能处理没见过的页面”。缺点也是这个:每次走的路径可能不一样。对财务来说,“不一样”就是风险。
Playwright 是另一条路。Apache-2.0,微软维护,写的是确定性脚本:打开哪个页面、点哪个按钮、等哪个元素、下载到哪个目录,全写死。页面改版它会报错,不会“自己猜一个”。
我的分工是这样的:
- 主流程用 Playwright。登录、列表、下载、改名,每一步写死,失败就停。
- browser-use 只做探索和兜底。第一次接一个新系统,我先让它跑一遍,看它怎么点,再把路径抄成 Playwright 脚本。
全交给 Agent 点,等于把审计风险交给运气。
举个我做过的例子:OA 里批量下载报销单附件。
流程不复杂:登录 → 进待办 → 筛选日期 → 打开每一单 → 下载附件 → 按单号建文件夹。
坑很多:登录态两小时过期;列表分页是异步加载;附件按钮有时在 iframe 里;下载目录会被浏览器重命名;有些单子根本没有附件。
最麻烦的不是下载,是命名。附件下下来叫 attachment(3).pdf,你得按单号、费用类型重命名,不然一个月后没人认得出。
Playwright 跑主流程,每一步失败都截图;browser-use 处理“这单的附件按钮位置不一样”这种意外。跑完,每一单都有一张截图、一条日志、一个操作人。
这三样东西,比“自动化”本身重要。财务的自动化,第一要求不是快,是出了事能查。
一条底线
能自动填,不能自动交。网银付款、税局申报、OA 审批,这些动作可以让 Agent 准备好,但最后一下必须是人点的。这不是技术问题,是责任问题。
财务专用件:少而精
通用的眼睛、计算器、手装好之后,才轮到财务专用件。
这部分我建议克制。GitHub 上“财务”标签下的项目,翻几页就会发现,很大一部分是个人记账、量化回测、加密货币,跟企业财务不是一回事。真正能用的,就那么几个。
OpenBB,现在把自己叫 Open Data Platform(ODP),5.0 版,Apache-2.0。它把不同来源的行情、财报、宏观数据统一成一套接口,还能通过 MCP server 挂给 Agent。一行代码:
from openbb import obb
df = obb.equity.price.historical("AAPL").to_dataframe()
做投研、做美股、做行业对标的,这个能省掉大量“找数据源、对字段”的时间。
akshare 是国内做 A 股数据最常用的库,MIT 协议,1.19 版。它覆盖股票、基金、债券、期货、宏观、行业,接口多到记不住。它最近加了一个对 Agent 很友好的东西:离线接口检索。
import akshare as ak
ak.search("可转债 实时行情", limit=5)
模型不用背接口名,先用一句话搜,再拿到接口名和参数,再调。这比在提示词里塞一本接口手册靠谱得多。
但 akshare 有个前提:数据是给研究用的,接口可能因为数据源变化而失效。生产环境要锁版本、加缓存、做校验,不能把它当“永远在线”的数据库。
edgartools 是给美股用的。MIT 协议,5.62 版,把 SEC 的 filings 变成结构化对象:利润表、资产负债表、现金流量表、13F 持仓、Form 4 内部人交易、N-PORT 基金持仓、8-K 事件。它还自带 MCP server 和 skill,Agent 装上就能查。
做跨境并购、竞品分析、美股财报的,这个能省几个月。SEC 的限流是每秒 10 次,它自己会控制。
Arelle 是 XBRL 解析器,Apache-2.0。XBRL 是财报的结构化标准,Arelle 能把实例文档和分类标准解析成可校验的对象。它不“好看”,但它是“原件”级的工具。做披露校验、准则研究、监管报送的会用得上。
beancount 是复式记账,GPL-2.0,纯文本。它不适合替换 ERP,但特别适合做“账务规则沙盒”:你想验证一套科目映射、一套结转规则,用 beancount 写几十笔分录,跑一遍,比在 ERP 里试错安全得多。
invoice2data 是发票字段提取,MIT 协议。它用模板 + OCR 把发票上的号码、金额、日期抽出来。国内发票要自己写模板,增值税专票、电子普票、行程单,各一套。它的好处是轻,坏处也是轻——复杂版式要自己维护。
| 项目 | 一句话 | 适合谁 | 别用在什么场景 |
|---|---|---|---|
| OpenBB | 行情、财报、宏观数据的统一接口 | 投研、美股、行业对标 | 国内 A 股实时行情 |
| akshare | 国内财经数据大杂烩 | A 股、宏观、行业 | 要求 7×24 稳定的生产库 |
| edgartools | SEC 文件结构化 | 美股、跨境、竞品 | 非美股公司 |
| Arelle | XBRL 解析与校验 | 披露、监管、准则 | 只想读 PDF 的人 |
| beancount | 复式记账沙盒 | 规则验证、账务测试 | 替代 ERP |
| invoice2data | 发票字段提取 | 报销、票夹 | 版式天天变的场景 |
我的建议是:一个数据源、一个解析器、一个记账沙盒,够你用半年。剩下的,等真的遇到再说。
编排:n8n、Dify 和 MCP
眼睛、计算器、手都有了,还差一件事:让它们按顺序跑,失败能重试,人能插手。
这就是编排。
n8n 是这两年被财务团队用得最多的一个。二十万星,可视化拖节点,能定时、能重试、能分支、能等人确认。它最大的优点是“看得见”——一条流程长什么样,财务经理也能看懂。
但它的协议要说清楚:Sustainable Use License,不是标准开源。自己公司内部用,免费;拿它对外提供商业服务,不行;带 .ee 的文件要商业授权。
这不是劝退,是提醒。用之前,先让法务看一眼。
Dify 更偏“LLM 应用”。十五万星,可视化编排 Agent、RAG、工具调用,国内生态好。它的协议是修改过的 Apache 2.0:多租户要商业授权,前端 LOGO 不能删。
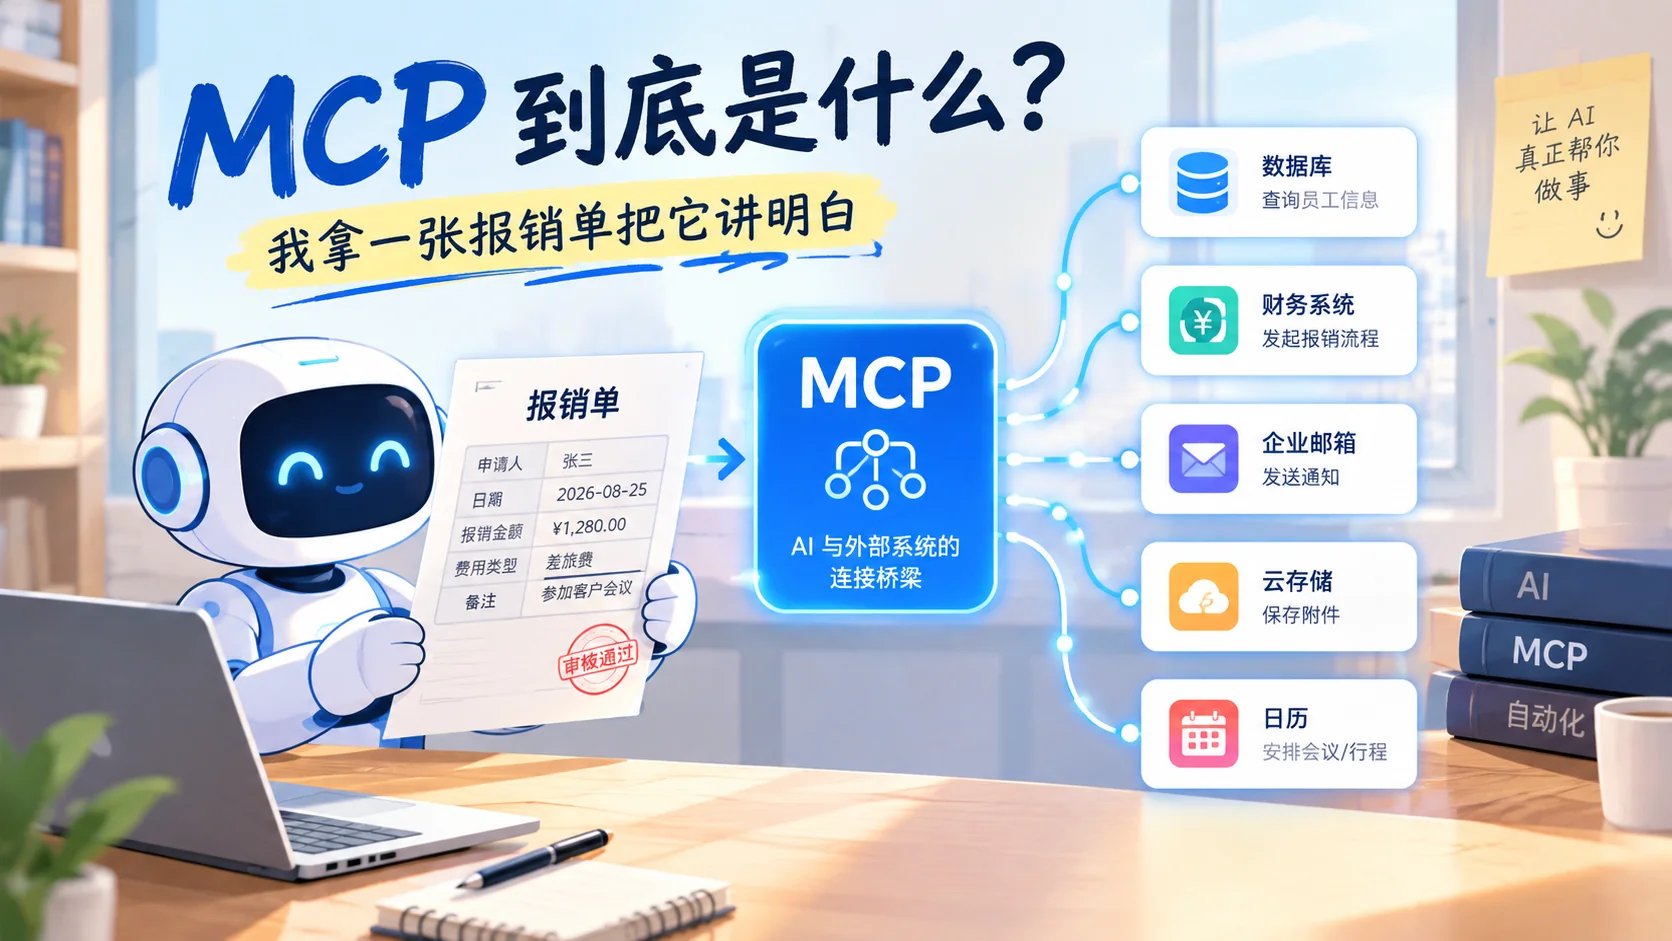
MCP 是另一层。它不负责编排,它负责“把工具变成标准接口”。你把 OA 的查询、下载、审批包成 MCP server,Agent 就能像调用函数一样调用它们,不用为每个模型写一套适配。
我自己给 OA 写过 MCP server,最深的一点体会是:MCP 不是魔法,它只是把“函数调用”这件事标准化了。真正花时间的,是把业务规则写清楚——哪些单能查、哪些字段能出、下载附件要不要审批。
一个最小可用的财务流程:
每月 1 号,n8n 定时触发 → 拉取上月订单和费用明细 → DuckDB 跑异常检测 → 生成异常清单 → 企业微信推给责任人 → 人工处理后回写状态。
AI 只在两个地方出现:写 SQL,和解释异常。其他步骤,都是普通程序。
这条流程不酷,但它能跑,能查,能停。
热榜上还有一类项目,做 Agent 的记忆,比如 claude-mem。我试过,对个人助理有用,对财务流程反而危险。财务要的是“每次都按同一份制度算”,不是“它记得上次怎么算”。可追溯的记录,比模型的回忆可靠。
选型:Star 是最不重要的指标
写到这,你大概看出来了:我选项目,不太看 star。
Star 只能说明“有多少人觉得它不错”,说明不了“它能不能用在财务上”。一个两万星的项目,可能半年没提交;一个两百星的项目,可能每周发版。
我看五件事:
- License。能不能内部用,能不能对外服务,有没有附加条件。
- 最近一次提交。半年没动,慎重;一年没动,除非它已经“完成”了。
- Issue 里的高频词。搜 table、OCR、timeout,看它死在哪些场景。
- 依赖重量。为了读一个 PDF,装三个 G 的模型,值不值。
- 能不能离线。财务数据出内网,很多事就结束了。
再加财务自己的三条:数据不出内网、操作可留痕、结果可复算。
License 这块,我画个红绿灯:
| 协议 | 内部用 | 对外服务 / 分发 | 备注 |
|---|---|---|---|
| MIT / Apache-2.0 | 可以 | 可以 | 保留版权声明 |
| GPL / AGPL | 通常可以 | 要小心 | 分发或网络服务有传染性 |
| EUPL | 可以 | 要小心 | 弱 copyleft |
| Sustainable Use | 可以 | 不行 | n8n 这类 |
| 附加条件(MinerU / Dify) | 看条款 | 看条款 | 不是标准开源 |
| 无 License | 默认保留全部权利 | 不行 | 最危险 |
这也是为什么我前面反复说“先看协议”。不是律师思维,是省钱思维——上线三个月被要求换掉,成本比一开始看一眼高得多。
热榜还有一个陷阱:它奖励“新”,不奖励“稳”。
一个项目这周涨五千星,很可能是因为发了一篇很酷的 demo。demo 里的 PDF 是干净的,表格是规整的,网络是通的。你拿自己那份扫描件一试,它连第一页都过不去。
Demo 能跑,不等于能上线。财务的失败成本不是 bug,是审计问题。
我卸掉的项目,大概分三类。一类是“平台”:装完先让我配数据库、配向量库、配权限,半天过去了,年报还没打开。一类是“全自动”:demo 里能自己规划、自己执行,真跑起来每一步都要我确认,比我自己点还慢。还有一类是“记忆”,上面说过了。
一个周末的最小组合
如果你这周末就想动手,我给你一个最小组合。
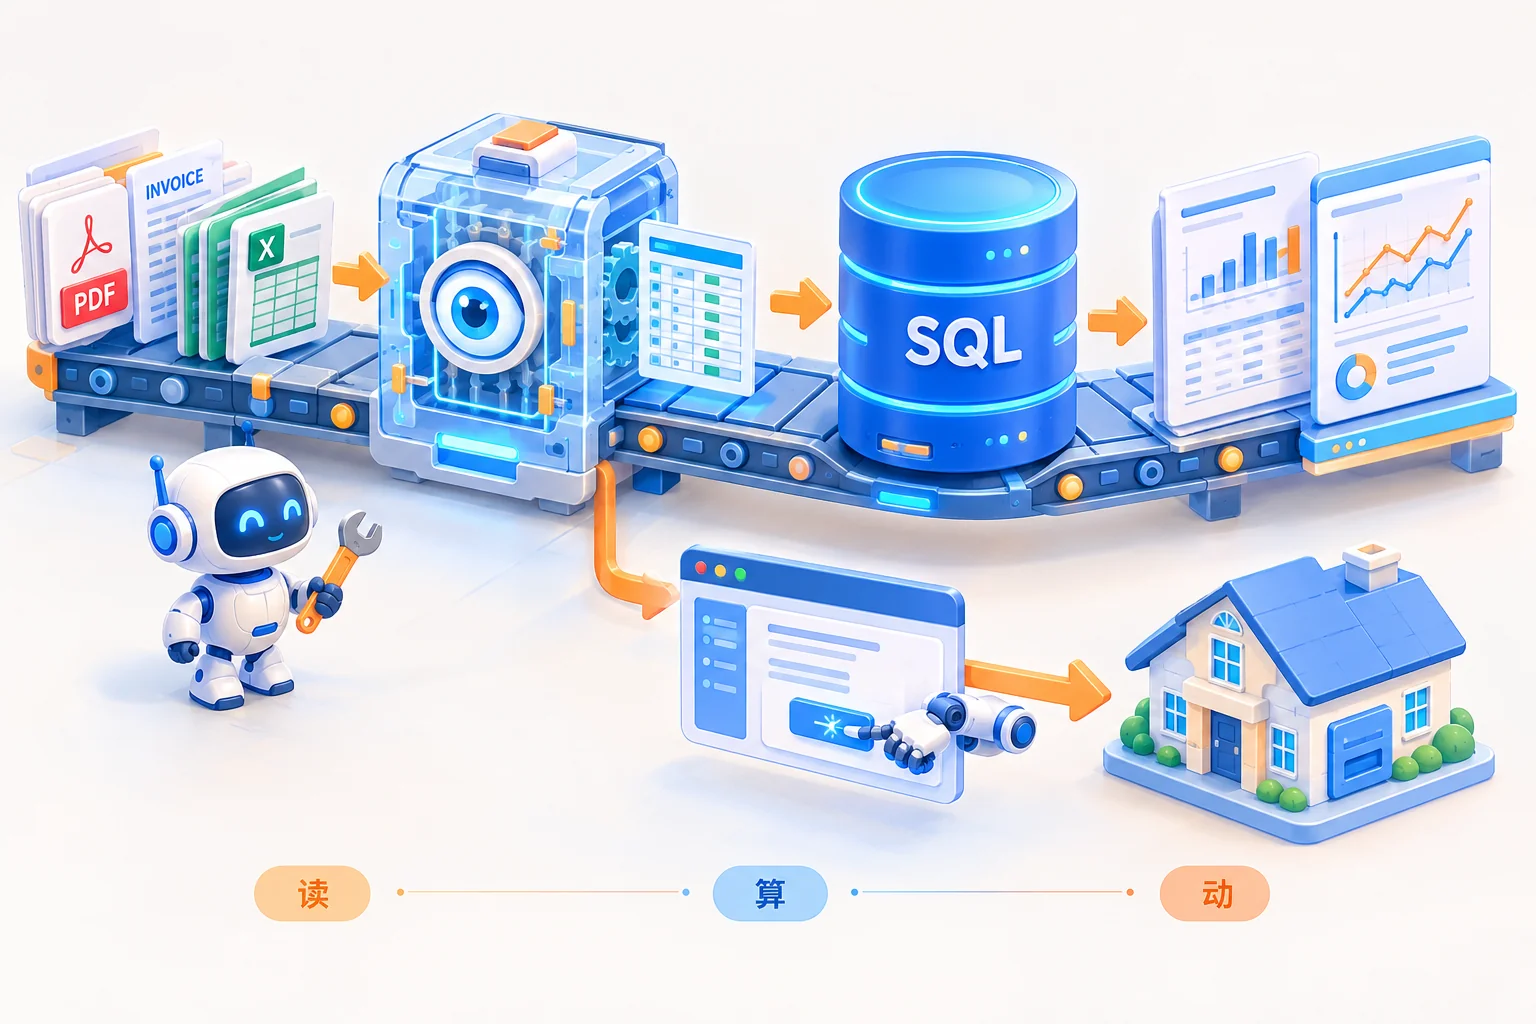
- 读:MinerU 或 Docling,选一个。中文文档多用 MinerU,英文和财报多用 Docling。
- 算:DuckDB,一个文件,一条命令装好。
- 动:Playwright,先写死一个最无聊的流程(下载、导出、改名),别一上来就点审批。
再加一个 n8n,把“定时”和“人工确认”接上。
如果你只有一台笔记本,别急着装本地大模型。解析和 SQL 都不需要 GPU,模型用 API 就行。等流程跑通了,再考虑要不要把模型搬回本地。
架构大概是:
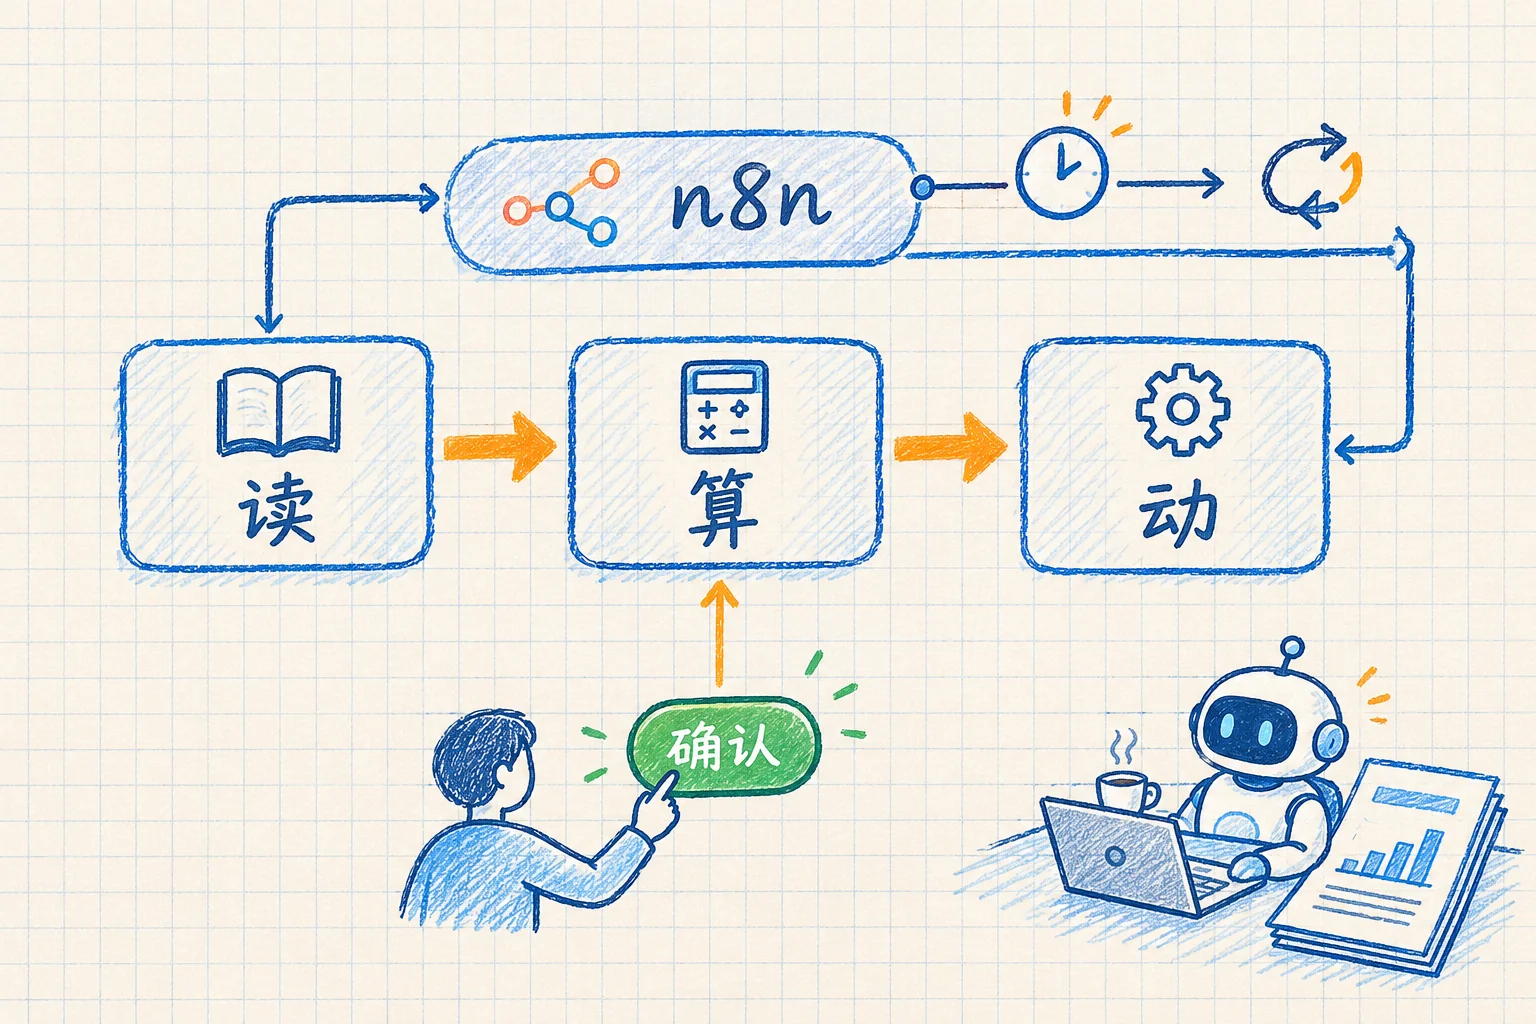
生成后放到 /blog/images/ 即可
时间表:
- 周六上午,装环境。用 uv 或 pipx 隔离,别装进系统 Python。
- 周六下午,拿一份真实的年报,跑通“读 → 算 → 出一张表”。
- 周日,专门做失败处理:表格错位怎么办,登录过期怎么办,金额单位不一致怎么办。
验收标准三条:
- 同一个问题问两遍,答案一样。
- 算错的时候,能指出错在第几步。
- 人随时能接手,不用重新跑一遍。
三条都过,再谈上线。
最后
回到那份年报。
Agent 还是那个 Agent,模型也没换。我只是给它装了三样东西:一个能读表格的解析器、一个能跑 SQL 的数据库、一个能点浏览器的脚本。它算对了。
但我更在意的不是它算对了,是它算错的时候,我知道它错在哪一步。
这一年 GitHub 上冲上热榜的项目,我装过十几个,卸掉的比留下的多。卸掉的原因都差不多:太重、太新、太不可控。
留下的这几个,没有一个是“最火”的。它们只是刚好补上了我缺的那一块。
所以如果你问我,财务 Agent 该怎么武装——我的答案不是“装得越多越好”,是先知道自己缺的是眼睛、计算器,还是手。
工具会过时。这三样不会。
本文提到的项目
- opendatalab/MinerU(文档解析,4.0;MinerU Open Source License)
- docling-project/docling(版面/表格/XBRL,MIT)
- microsoft/markitdown(Office 转 Markdown,MIT)
- duckdb/duckdb(本地分析数据库,MIT)
- dream-num/univer(表格/文档 SDK,Apache-2.0)
- browser-use/browser-use(浏览器 Agent,MIT)
- microsoft/playwright(确定性浏览器自动化,Apache-2.0)
- OpenBB-finance/OpenBB(金融数据平台,Apache-2.0)
- akfamily/akshare(国内财经数据,MIT)
- dgunning/edgartools(SEC 文件结构化,MIT)
- Arelle/Arelle(XBRL 解析,Apache-2.0)
- beancount/beancount(复式记账,GPL-2.0)
- invoice-x/invoice2data(发票字段提取,MIT)
- n8n-io/n8n(流程编排,Sustainable Use License)
- langgenius/dify(LLM 应用编排,修改版 Apache 2.0)
版本号和协议来自各项目仓库与 PyPI,star 数据来自 2026 年 10 月 20 日的 GitHub 榜单。核对时间 2026 年 10 月 21 日。热榜排名每天变,协议不会天天变——用完之前,还是自己再看一眼 LICENSE。